


OpenAI 在上上個禮拜發布了 GPT-6 Astra。
網路上各方評價都非常驚人,有人甚至聲稱 Astra 就是 AGI(通用人工智慧);不過它的價格和額度消耗,看起來也很驚人。
如果 Astra 是目前最強的 OpenAI 模型,我們是不是應該把所有工作都交給它?
當然不是。
我相信總有一天,我們不需要去選擇要使用什麼模型,而是 AI 能夠完成我們日常中幾乎所有的電腦工作。
不過在AGI 到來前,我們還是要先決定「哪一種工作值得使用最強的模型」,把錢花在刀口上。
各位好,我是 Raven,目前專注於研究 AI 工具與自動化流程。
今天這一集,我想先帶大家認識OpenAI 最新的旗艦模型 Astra,並且討論如何建立一套實際的模型分工方式。
Astra 到底是什麼?
OpenAI 在 2026 年 9 月 3 日發布 GPT-6 Astra,它是 OpenAI 以超過 10 萬顆 GPU 訓練的新模型,黃仁勳甚至聲稱 AGI 來了。
Astra 這個英文單字意味著星辰,剛好跟OpenAI 的其他模型 Sol(太陽)、Terra(地球)、Luna(月亮)是一組的。
依照 OpenAI 的定位,Astra 是目前能力最高的模型,專門處理最困難的端到端工作。
這裡所謂的「端到端」,意思是從理解需求、蒐集資料、使用工具、修改檔案,一路把工作給做完。
換句話說,我們人類就是負責開需求給它,由它負責完成任務。
所以 OpenAI 認為 Astra 特別適合複雜推理、程式開發、電腦操作、研究,以及文件、簡報和試算表的製作。
不過,實際測試真的是這樣嗎?
Astra 的評分(benchmark)到底有多強?
Astra 是真的很強。
它在多階段工具操作、跨檔案推理和陌生環境的探索上,跟前一代相比有非常明顯的進步。
例如 OpenAI 公布的 Terminal-Bench 4.0,是一個測試 AI 能不能在終端機裡完成複雜工作的基準測試。
Astra 得到 57.9%,GPT-5.6 Sol 是 37.3%,差距非常的巨大。
另一個 Terminal-Bench Science 0.1,測的是更複雜的科學研究工作流。
例如分析科學數據、執行電腦模擬,或調整數學模型的參數,讓計算結果盡可能符合觀測資料。
在這個測試中,Astra 得到 64.6%,Sol 只有 22.4%。
還有一個測驗是讓 Astra 玩一組陌生的互動遊戲(ARC-AGI-3)。
遊戲沒有說明書,研究人員也不會先告訴它規則,或直接教它怎麼過關。
Astra 得先觀察畫面,試著做一個動作,再看畫面發生什麼變化。
接著,它要從這些變化裡摸索規則,判斷要達成什麼目標,再安排下一步。
如果結果跟預期不同,就得回頭修正自己的理解。
團隊採用了兩個運作方式。
第一種是各家模型共用的標準架構,讓模型自己留下筆記,記錄已經發現的規則、目前的位置,以及還沒完成的計畫。
在這套架構下,Astra 的最佳成績是 62.7%。
第二種則接上 OpenAI 自己提供的上下文管理功能。
除了筆記,系統還能保留前一步的內部推理狀態,讓 Astra 接著原本的工作往下做。
對話太長時,也會壓縮、整理上下文,供後續繼續使用。
搭配這套運作方式,最佳成績居然來到 99.9%。
由此來看,OpenAI 自己做的 Harness 架構還是挺適合他們自己的模型。
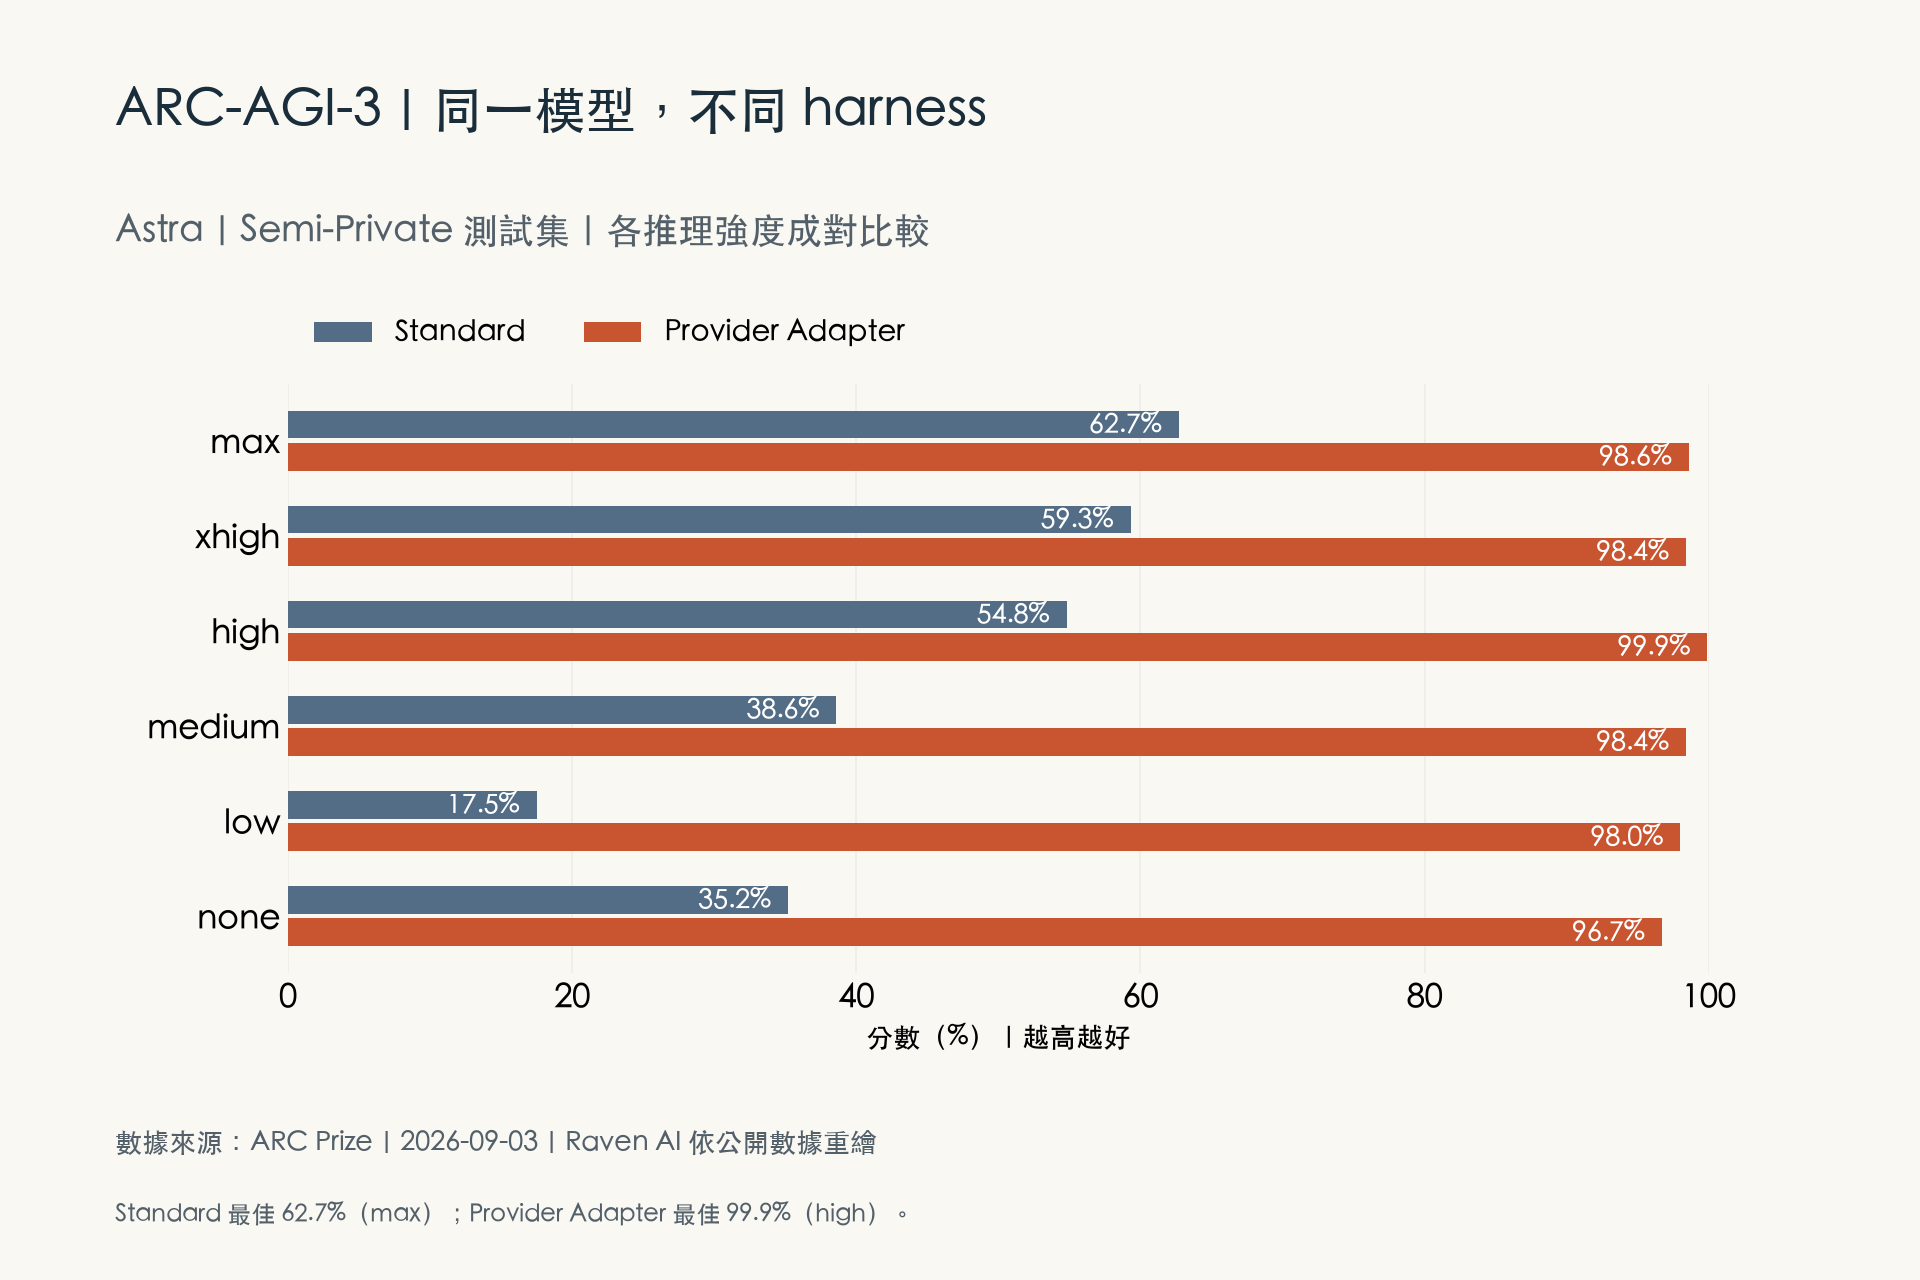
圖表依 ARC Prize 原始結果重繪,使用 Semi-Private 測試集。同一列比較相同推理強度;max 是 62.7% 對 98.6%,high 是 54.8% 對 99.9%。這裡比較的是兩套完整運作方式,並未分離個別功能的效果。
因此,如果工作需要長時間使用工具、分析資料,還要經過很多階段才能完成,Astra 的優勢看起來相當明顯。
所以 Astra 全面碾壓其他模型了嗎?也不盡然。
在單純程式開發環境中,Astra 表現並不特別突出。
例如在 DeepSWE v1.1 這個程式開發測試裡,Astra 是 74.1%,Sol 是 72.7%,差距挺小的。
所以單純只是開發程式,實在沒必要叫出 Astra,畢竟它比較貴嘛。
我們不能看到幾個很高的分數,就說 Astra 每一種程式工作都比 Sol 強很多。
那如果不跟自家的 Sol 比,而是跟 Anthropic 的旗艦模型 Claude Fable 5.1 比呢?
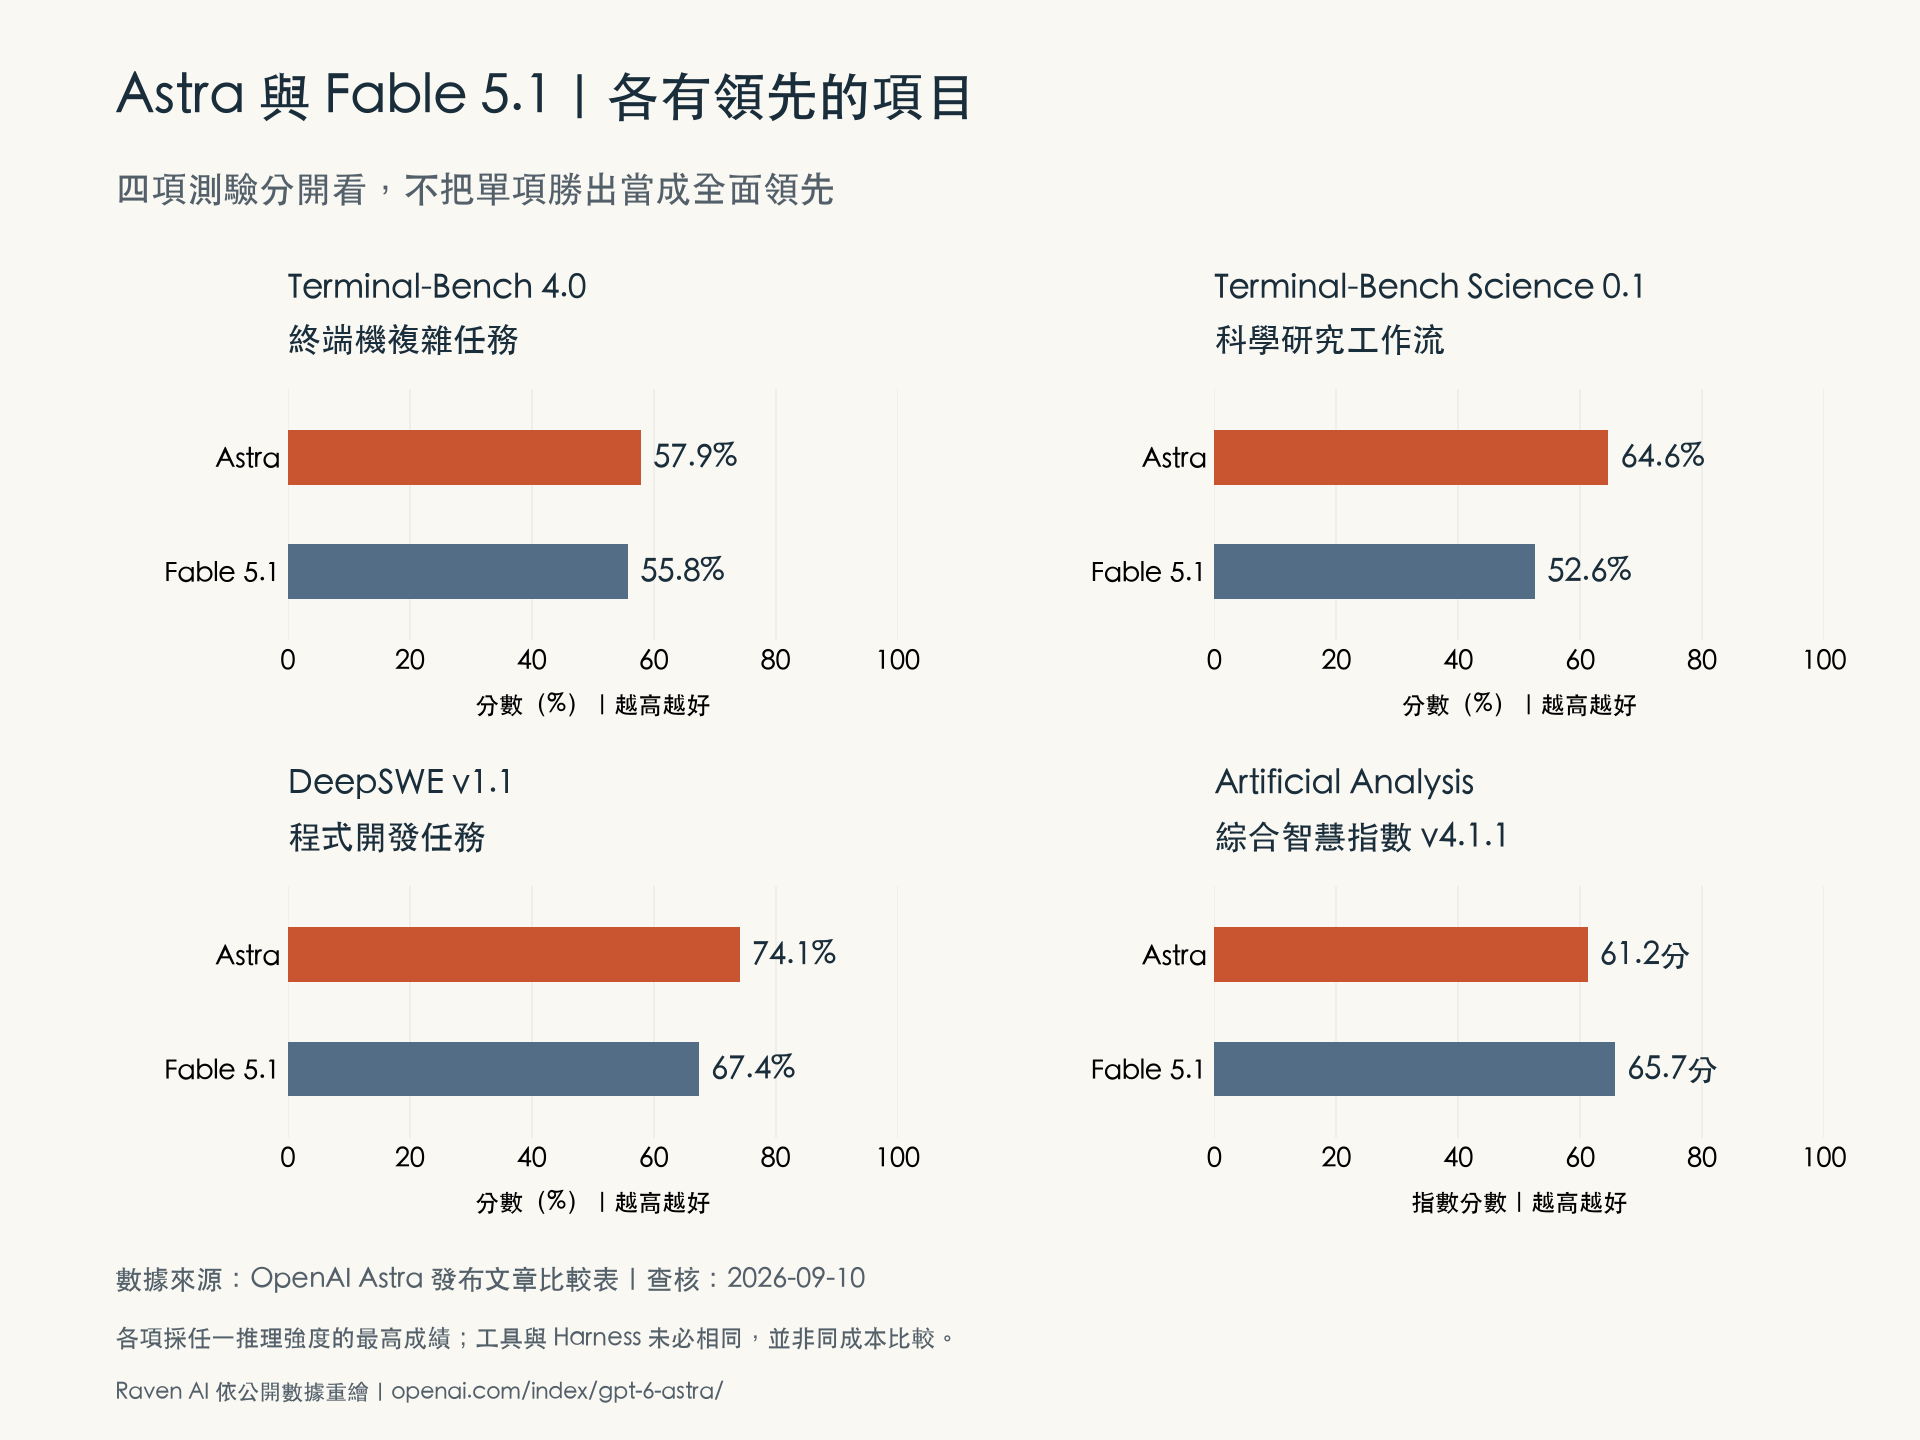
就算是拿 OpenAI 發布文章裡的數字放在一起,就會發現,Astra 也不是每一項都贏。
先看剛才的 Terminal-Bench 4.0,也就是終端機裡的複雜任務。Astra 是 57.9%,Fable 5.1 是 55.8%,只差 2.1 個百分點,並沒有像跟 Sol 比的時候差那麼多。
但換到科學研究工作流,差距就拉開了。在 Terminal-Bench Science 0.1 裡,Astra 是 64.6%,Fable 5.1 是 52.6%,Astra 領先了 12 個百分點。
程式開發也是 Astra 領先。剛才提到的 DeepSWE v1.1,Astra 拿到 74.1%,Fable 5.1 則是 67.4%。
聽到這裡,好像都是 Astra 贏?
不過,如果看 Artificial Analysis 的綜合智慧指數 v4.1.1,結果就反過來了:Fable 5.1 是 65.7 分,Astra 是 61.2 分。
所以,比較合理的解讀是:Astra 在需要動手完成工作的測試裡都很有競爭力, 不過論綜合智慧恐怕還是略輸給 Fable 5.1。
Astra 很貴,所以要自己判斷工作本身的結構
所以 Astra 很強,那是不是直接把 Astra 當作預設模型就好了?
也不能這樣搞。
因為 Astra 貴得很呢,每一百萬個輸入 tokens 10 美元,輸出則是 50 美元。
至於 Sol 是輸入 4 美元、輸出 20 美元,相比之下,Astra 貴了一倍以上。
如果你願意用更低階的模型,當然就更便宜了,例如 Terra 是輸入 2 美元、輸出 12 美元。
至於 Luna 輸入只有 0.2 美元、輸出 1.2 美元。
既然如此,應該要怎麼選呢?
只看單價,Astra 非常貴,但是這也不是說,那就少用 Astra 。
我們應該要考慮,完成一個可以接受的成果,總共會花多少錢和時間。
假設貪便宜,先讓便宜的模型測試,結果連續失敗好幾次,最後得換成 Astra,前面的等待、檢查也都是成本。
反過來說,如果工作本來很簡單,讓 Terra 或 Luna 一次就能做對,使用 Astra 就只是浪費額度而已。
所以最合理的方法,不是永遠用最強模型,也不是所有工作都先用最便宜模型。
而是先判斷工作本身的結構。
還在思考怎麼做,那就先用 Sol
如果你還沒想清楚工作要怎麼做、資料要怎麼整理,或者幾個 App 之間要怎麼接起來,我不建議先從便宜的模型下手,例如 Luna 或 Terra。
這個階段的工作,需要的是探索和判斷。
如果你的工作都是辦公室的文書工作,比方說你需要:
讓 AI 每週整理工作報告,但還沒決定要讀哪些信件、文件和試算表,也不知道報告該保留什麼。
把會議紀錄轉成待辦事項,再整理進 Notion 或任務管理 App,但負責人、期限和分類規則還沒想清楚。
手上有幾篇研究文章,希望先比較不同觀點,決定簡報要怎麼講,而不是直接把資料貼進投影片。
這些工作可以先用 Sol。
我會先讓 Sol 幫忙釐清需求、整理資料關係,把工作步驟和驗收方式定下來。
過程中如果需要讓 Sol 寫一小段程式來轉換檔案、串接工具,也可以一起處理。
因此以我自己的工作來說,我的預設模型都是用 Sol。
問題非常複雜,又跨資料,才用 Astra
Astra 比較值得出場的時機,是你確定問題很複雜,而且資料散落在不同檔案和 App 裡,不能只靠整理格式就得到答案。
比如說,
要整理一份專案決策報告,但客戶信件、會議紀錄和進度表互相矛盾,需要追查哪個決定已經被更新、哪些承諾還沒完成。
要把一批舊專案資料移到新的知識庫,卻發現文件有重複版本、互相引用,還有不同的存取權限,需要先理清哪些要保留、哪些不能分享。
一條跨表單、試算表和任務管理 App 的工作流,偶爾會漏掉資料,需要對照各處紀錄,找出問題出在哪一步。
這類工作需要長時間追查線索、比較不同來源,再判斷下一步,就要使用 Astra。
流程已經想清楚,交給 Terra 執行
我自己很少主動使用 Terra,但是如果是固定的排程的話,已經把資料來源、工作步驟和成果格式都決定了,就可能交給 Terra。
我會把 Terra 放在「仍然需要理解內容,但不用重新設計整個流程」的位置。
例如:
讀取指定資料夾的會議紀錄,依已確認的規則整理負責人、期限和待辦事項,缺少資訊就標記待確認。
按固定步驟彙整試算表,套入每週報告模板,附上來源,存成文件草稿供人檢查。
依既定分類規則,把文件整理到對應的知識庫位置,遇到重複檔案或分類不明的內容就停下來回報。
用既有工具把表單資料整理成任務草稿,核對筆數和必要欄位,確認沒有漏資料。
所以,如果技能裡的流程已經實際跑過,工具也準備好了,就應該使用 Terra 模型。
不過這個做法有一個前提。
你的技能(也就是流程 SOP)不能只是寫清楚說要怎麼做,更重要的是要怎麼樣判斷正確與否,以及遇到什麼情況必須要停下來,讓人類來複核。
你可以先拿幾份真實的資料跑看看,確認成果品質和檢查成本都能接受,再把這類固定工作交給 Terra。
幾乎只剩照格式做,才用 Luna
我幾乎沒在用 Luna。
因為 Luna 適合的是更固定的工作。
例如:
從格式一致的報名資料裡,抽出姓名、日期和聯絡方式,填進固定欄位。
把已經確認好的待辦清單,轉成另一個 App 可以匯入的表格格式。
根據明確的關鍵字對文件加上標籤,無法判定的就留給人處理。
把核准過的文字和數字,填進固定的通知模板,不自行補寫或更改內容。
這類的任務,通常我就直接這樣 Terra 做掉,所以其實比較少機會我會用到 Luna。
網路上有網友推薦使用 Luna 搭配思考 Max ,據說可以取代 Sol 的低度思考狀態,只是我測試了幾次也沒有很滿意。
所以我推薦是,如果你有一整套的工作流,然後你有某個小部分需要做簡單的判斷,那麼你就可以透過 API 或者是呼叫 sub-agent 的方式來使用 Luna。
五個問題,決定這次該用哪個模型
實際開始工作以前,我們可以先問自己五個問題。
第一,要交付什麼、要照哪些步驟做,已經說清楚了嗎?
第二,必要的資料和檔案,已經知道在哪裡嗎?
第三,結果能不能檢查?例如筆數有沒有對上、欄位有沒有遺漏、引用能不能找到原文?
第四,做錯的影響小嗎?可以輕易復原嗎?
第五,是照既定規則整理就好,還是需要判斷資料衝突、理解例外,甚至重新決定做法?
如果還在思考怎麼做,或不知道該用哪些資料,那就先用 Sol 一起規劃,或者讓它直接把任務完成。
假設需要跨很多來源追查線索、釐清矛盾,就直接升級到 Astra。
如果是例行性任務,而且你已經設定好流程,步驟清楚、資料確定、成果容易檢查,而且做錯也能復原,可以先測試 Terra 看看會不會出錯,然後設定排程。
最後,如果真的是超簡單任務,工作高度重複、格式固定,甚至可以考慮 Luna。
想建立一人公司,可以試試我的開源工具包
如果你也想把這套模型分工方式,真正放進自己的一人公司工作流,我最近開發了一套開源的「Raven AI 一人公司工具包」。
它把內容製作、Google 工具自動化、AI 知識庫、社群媒體管理和官網建置等工作,整理成 AI Agent 可以照著執行,也能檢查成果的技能包。
目前專案還在 Preview 階段,尚未正式支援,不過已經開放給大家免費安裝與測試。
歡迎到 GitHub 下載使用,只要把連結貼給你的 AI Agent ,如 ChatGPT ,它就知道怎麼做了。
也歡迎把實際遇到的問題回報給我,幫助我把它改得更適合一人公司。
相關連結
社畜進化論|Raven AI
如果你也想把 AI 從聊天工具變成真正能夠進入工作流程的 Agent,歡迎加入我的 Skool 社群「社畜進化論|Raven AI」。
裡面可以一起交流導入方式、分享實作成果,也一起處理權限、驗證與自動化流程中遇到的問題。